先说结论:大模型会给出每次不同的结果,但这不等于公平随机。
这次让六个大模型直接摇出 3,072 个有效六爻卦。若它们真的像三枚公平铜钱一样工作,64 卦长期看应该差不多平均,每卦约出现 48 次。实际第一名水火既济出现了 482 次,第二名乾为天出现了 330 次;有些卦却极少出现。更关键的是,只换一种问法,同一个模型最常生成的卦就可能完全改变。
所以这次测到的不是一个永恒不变的“模型性格”,而是更具体的事实:在这四种提示方式下,这些模型生成 0 和 1 时存在明显、而且受问法影响的偏好。
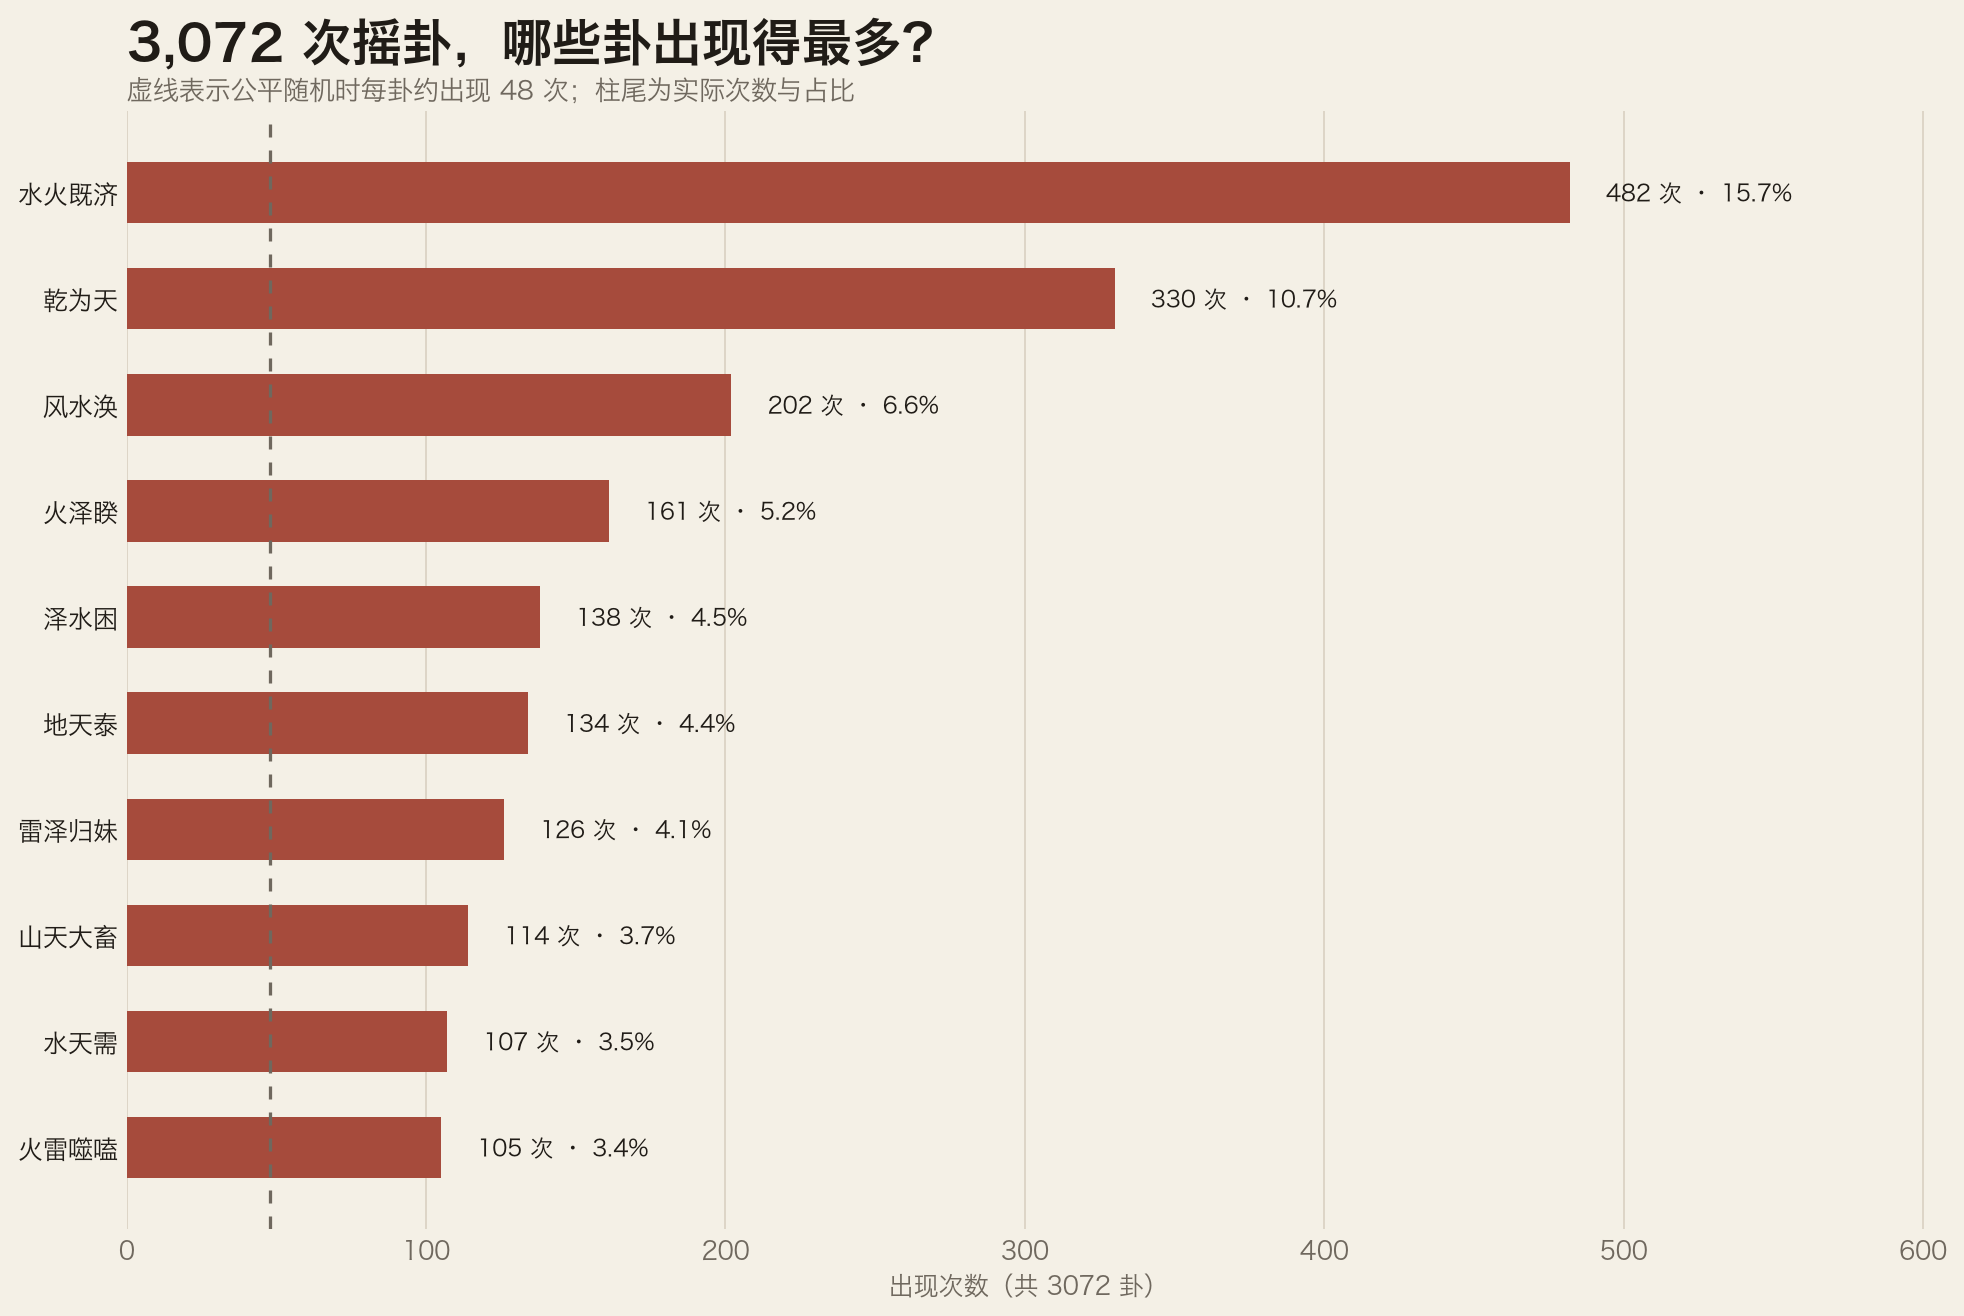
图一:全部模型和问法合并后的前十卦。虚线表示公平随机时每卦约 48 次。
实验到底怎么做
实验里不是先让程序掷铜钱,再把卦交给模型。**每一枚“铜钱”的 0 或 1 都由模型直接生成。**程序只负责三件事:检查格式、按固定规则排卦、统计结果。它不会在模型失败时偷偷补随机数,也不会改写有效结果。
这次共测试六个通过 OpenRouter 实际调用的模型:
- GPT-5.5:
openai/gpt-5.5 - Claude Opus 4.8:
anthropic/claude-opus-4.8 - Gemini 3.1 Pro:
google/gemini-3.1-pro-preview - DeepSeek V4 Pro:
deepseek/deepseek-v4-pro - Qwen 3.7 Max:
qwen/qwen3.7-max - GLM-5.2:
z-ai/glm-5.2
每个模型接受四种问法,每种问法保留 128 个有效完整卦。因此是:
6 个模型 × 4 种问法 × 128 个有效卦 = 3,072 个完整卦。
四种问法分别是:
- 说到铜钱,一次生成六爻:明确告诉模型模拟三枚铜钱,并一次给出六爻。
- 不说铜钱,一次生成六爻:只要求给出六组 0/1,不使用铜钱叙事。
- 说到铜钱,一次给出全部数字:连续输出组成一个卦所需的 18 位 0/1。
- 说到铜钱,逐爻生成:每次只生成一爻的三枚铜钱,六次合成一个卦。
所有组都使用相同的有效样本数。无效格式只会重试,不进入统计;最终比较的是每组 128 个有效卦,而不是谁更容易按格式回答。
总体结果:第一名是公平预期的十倍
3,072 个结果平均分给 64 卦时,每卦应为 48 次。实际前十名如下:
| 排名 | 卦象 | 出现次数 | 占全部结果 |
|---|---|---|---|
| 1 | 水火既济 | 482 | 15.7% |
| 2 | 乾为天 | 330 | 10.7% |
| 3 | 风水涣 | 202 | 6.6% |
| 4 | 火泽睽 | 161 | 5.2% |
| 5 | 泽水困 | 138 | 4.5% |
| 6 | 地天泰 | 134 | 4.4% |
| 7 | 雷泽归妹 | 126 | 4.1% |
| 8 | 山天大畜 | 114 | 3.7% |
| 9 | 水天需 | 107 | 3.5% |
| 10 | 火雷噬嗑 | 105 | 3.4% |
水火既济的 482 次,是公平预期 48 次的约 10 倍。总体分布的卡方统计量是 8,553.0(63 个自由度),偏离均匀分布的程度远不是普通的小幅波动。
这里的“偏好”是一个很朴素的说法:某些卦明显更常被生成。它不是模型能力排名,也不是在说哪一卦“更好”。
问法一换,最常出现的卦也会换
把四种问法分开看,差异更清楚:
| 问法 | 最常出现的卦 | 次数 | 该问法中的比例 |
|---|---|---|---|
| 说到铜钱,一次生成六爻 | 水火既济 | 179 / 768 | 23.3% |
| 不说铜钱,一次生成六爻 | 水火既济 | 200 / 768 | 26.0% |
| 说到铜钱,一次给出全部数字 | 水火既济 | 103 / 768 | 13.4% |
| 说到铜钱,逐爻生成 | 乾为天 | 330 / 768 | 43.0% |
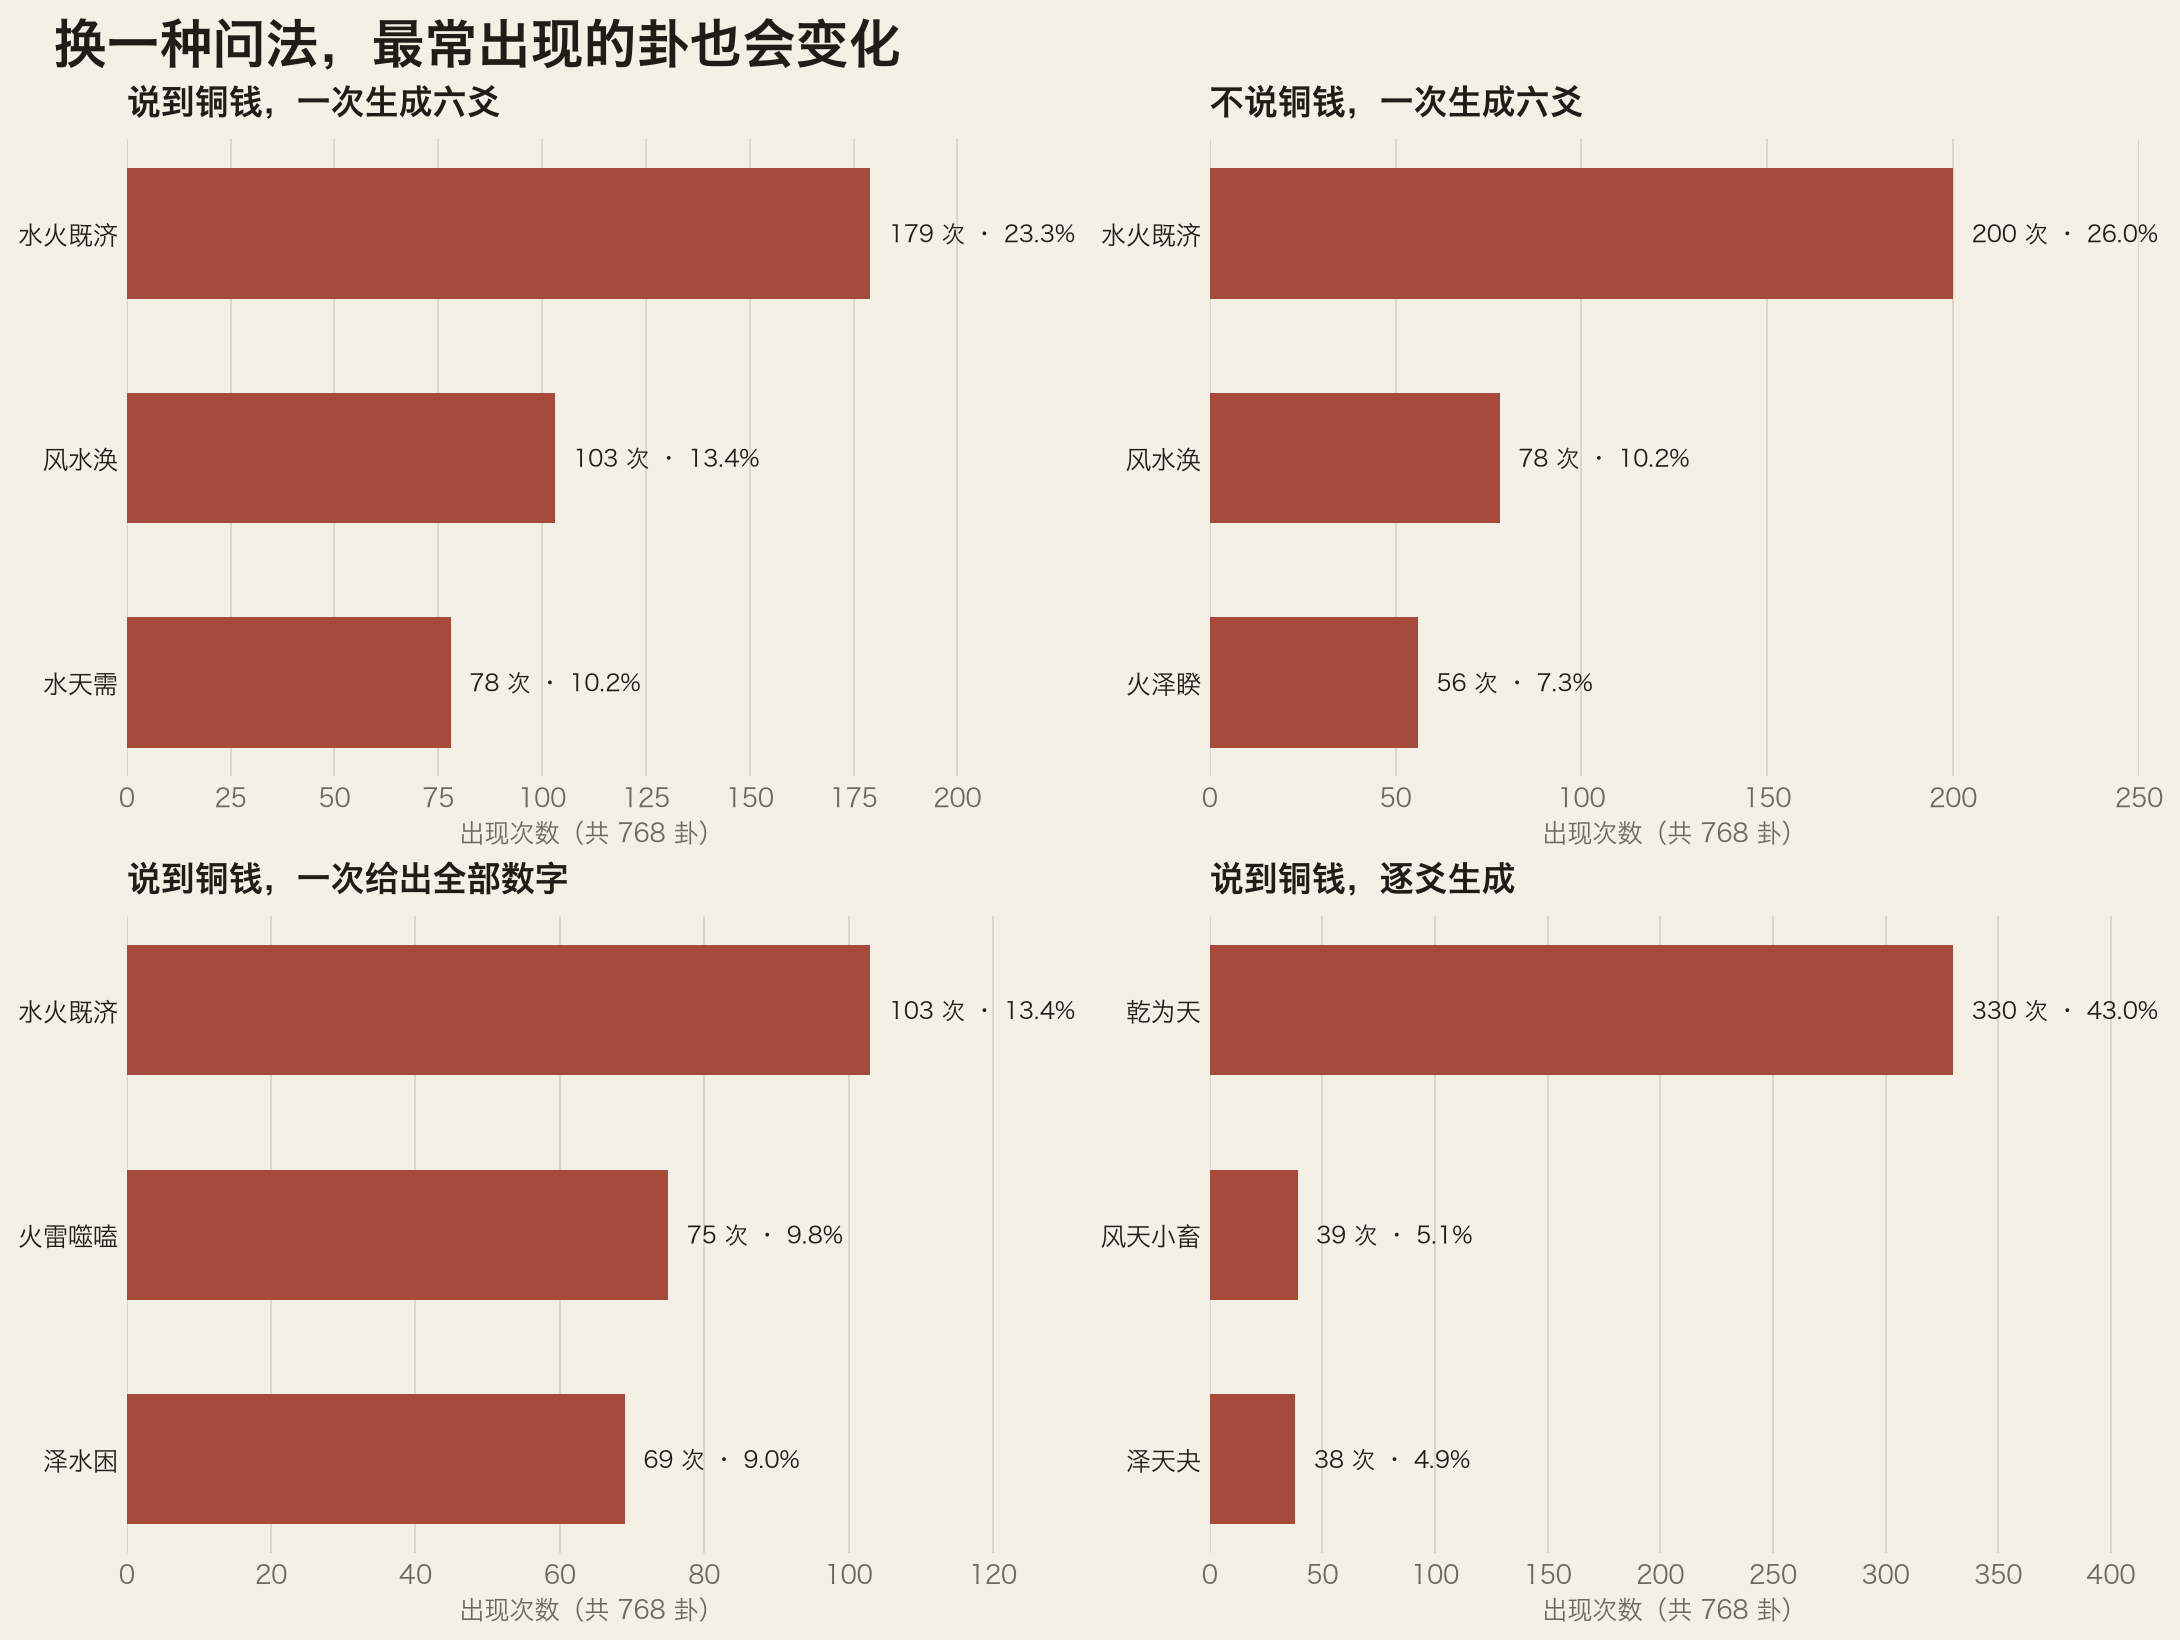
图二:每种问法都有 768 个有效卦。逐爻生成时,整体第一名从水火既济变成了乾为天。
“一次生成”和“逐爻生成”看起来只是输出方式不同,但对语言模型来说并不是同一件事。一次写完时,模型在同一段上下文里续写多位数字;逐爻请求时,生成边界和可见上下文都变了,后面的概率也随之改变。
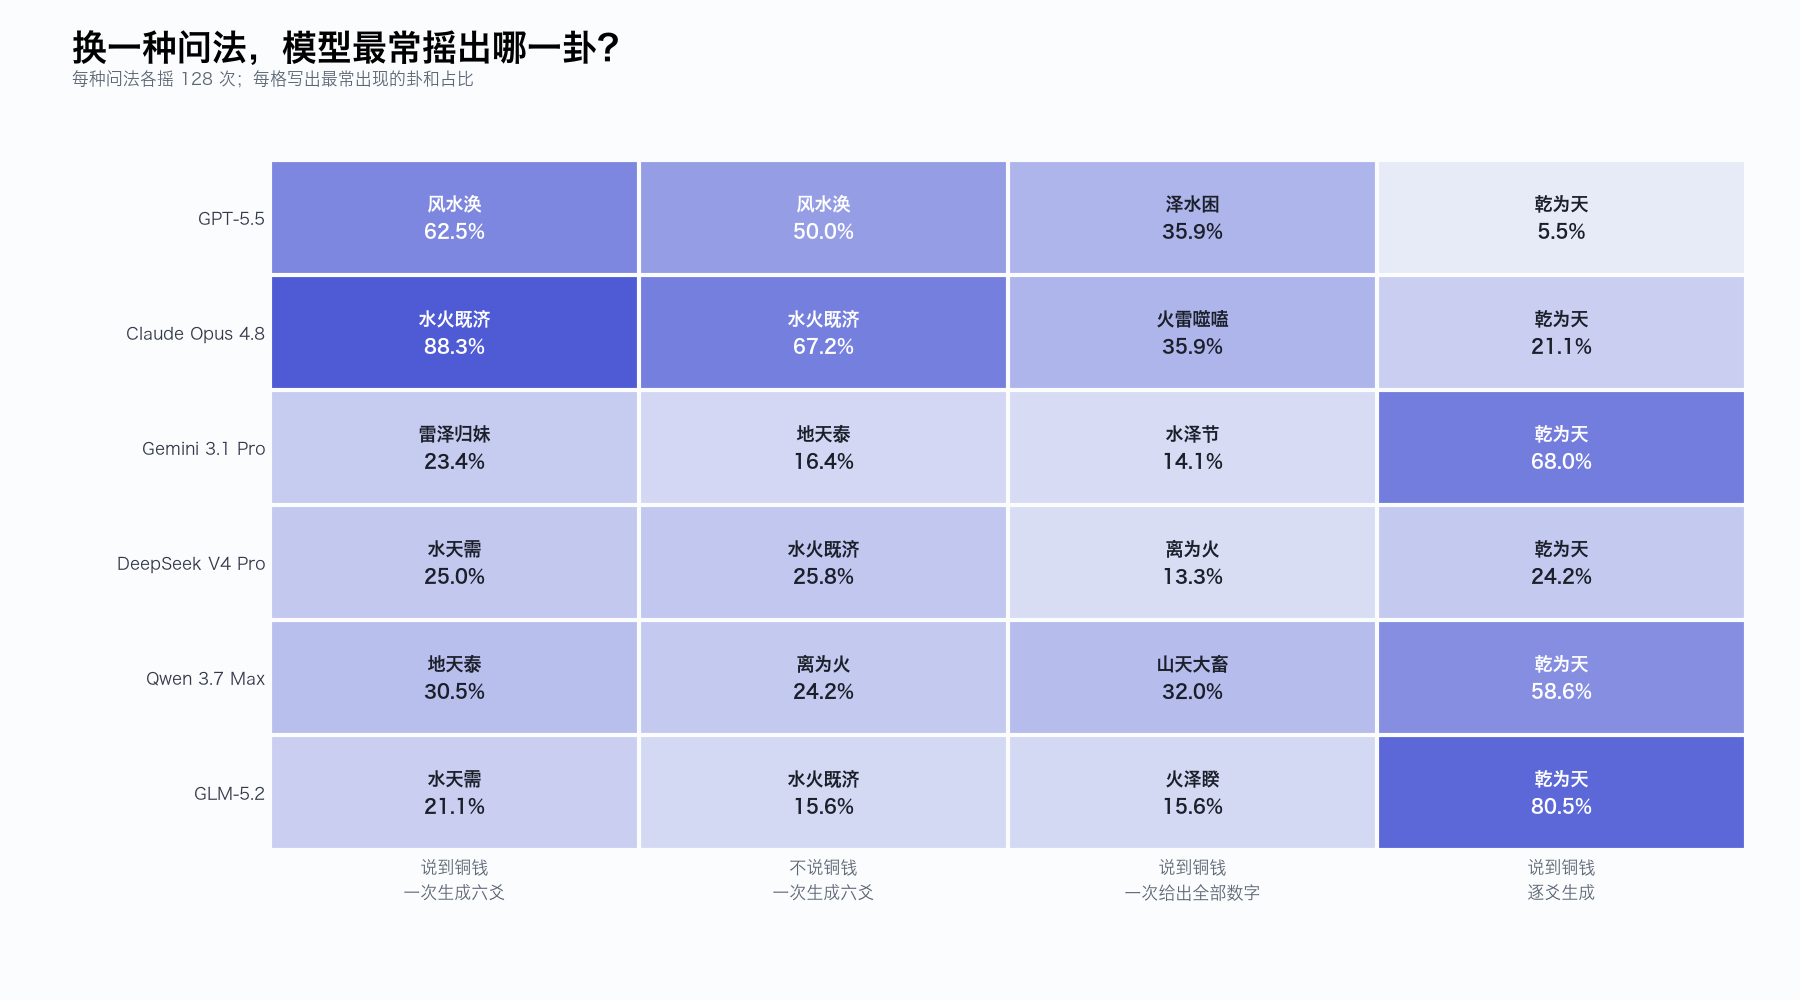
图三:每一行是一个模型,每一列是一种问法;格子直接写出该组最常生成的卦。
六个模型,各自最常生成什么
把四种问法合并,每个模型都有 512 个有效卦。它们的整体第一名是:
| 模型 | 最常出现的卦 | 次数 | 该模型中的比例 |
|---|---|---|---|
| GPT-5.5 | 风水涣 | 164 / 512 | 32.0% |
| Claude Opus 4.8 | 水火既济 | 237 / 512 | 46.3% |
| Gemini 3.1 Pro | 乾为天 | 87 / 512 | 17.0% |
| DeepSeek V4 Pro | 水风井 | 47 / 512 | 9.2% |
| Qwen 3.7 Max | 乾为天 | 75 / 512 | 14.6% |
| GLM-5.2 | 乾为天 | 103 / 512 | 20.1% |
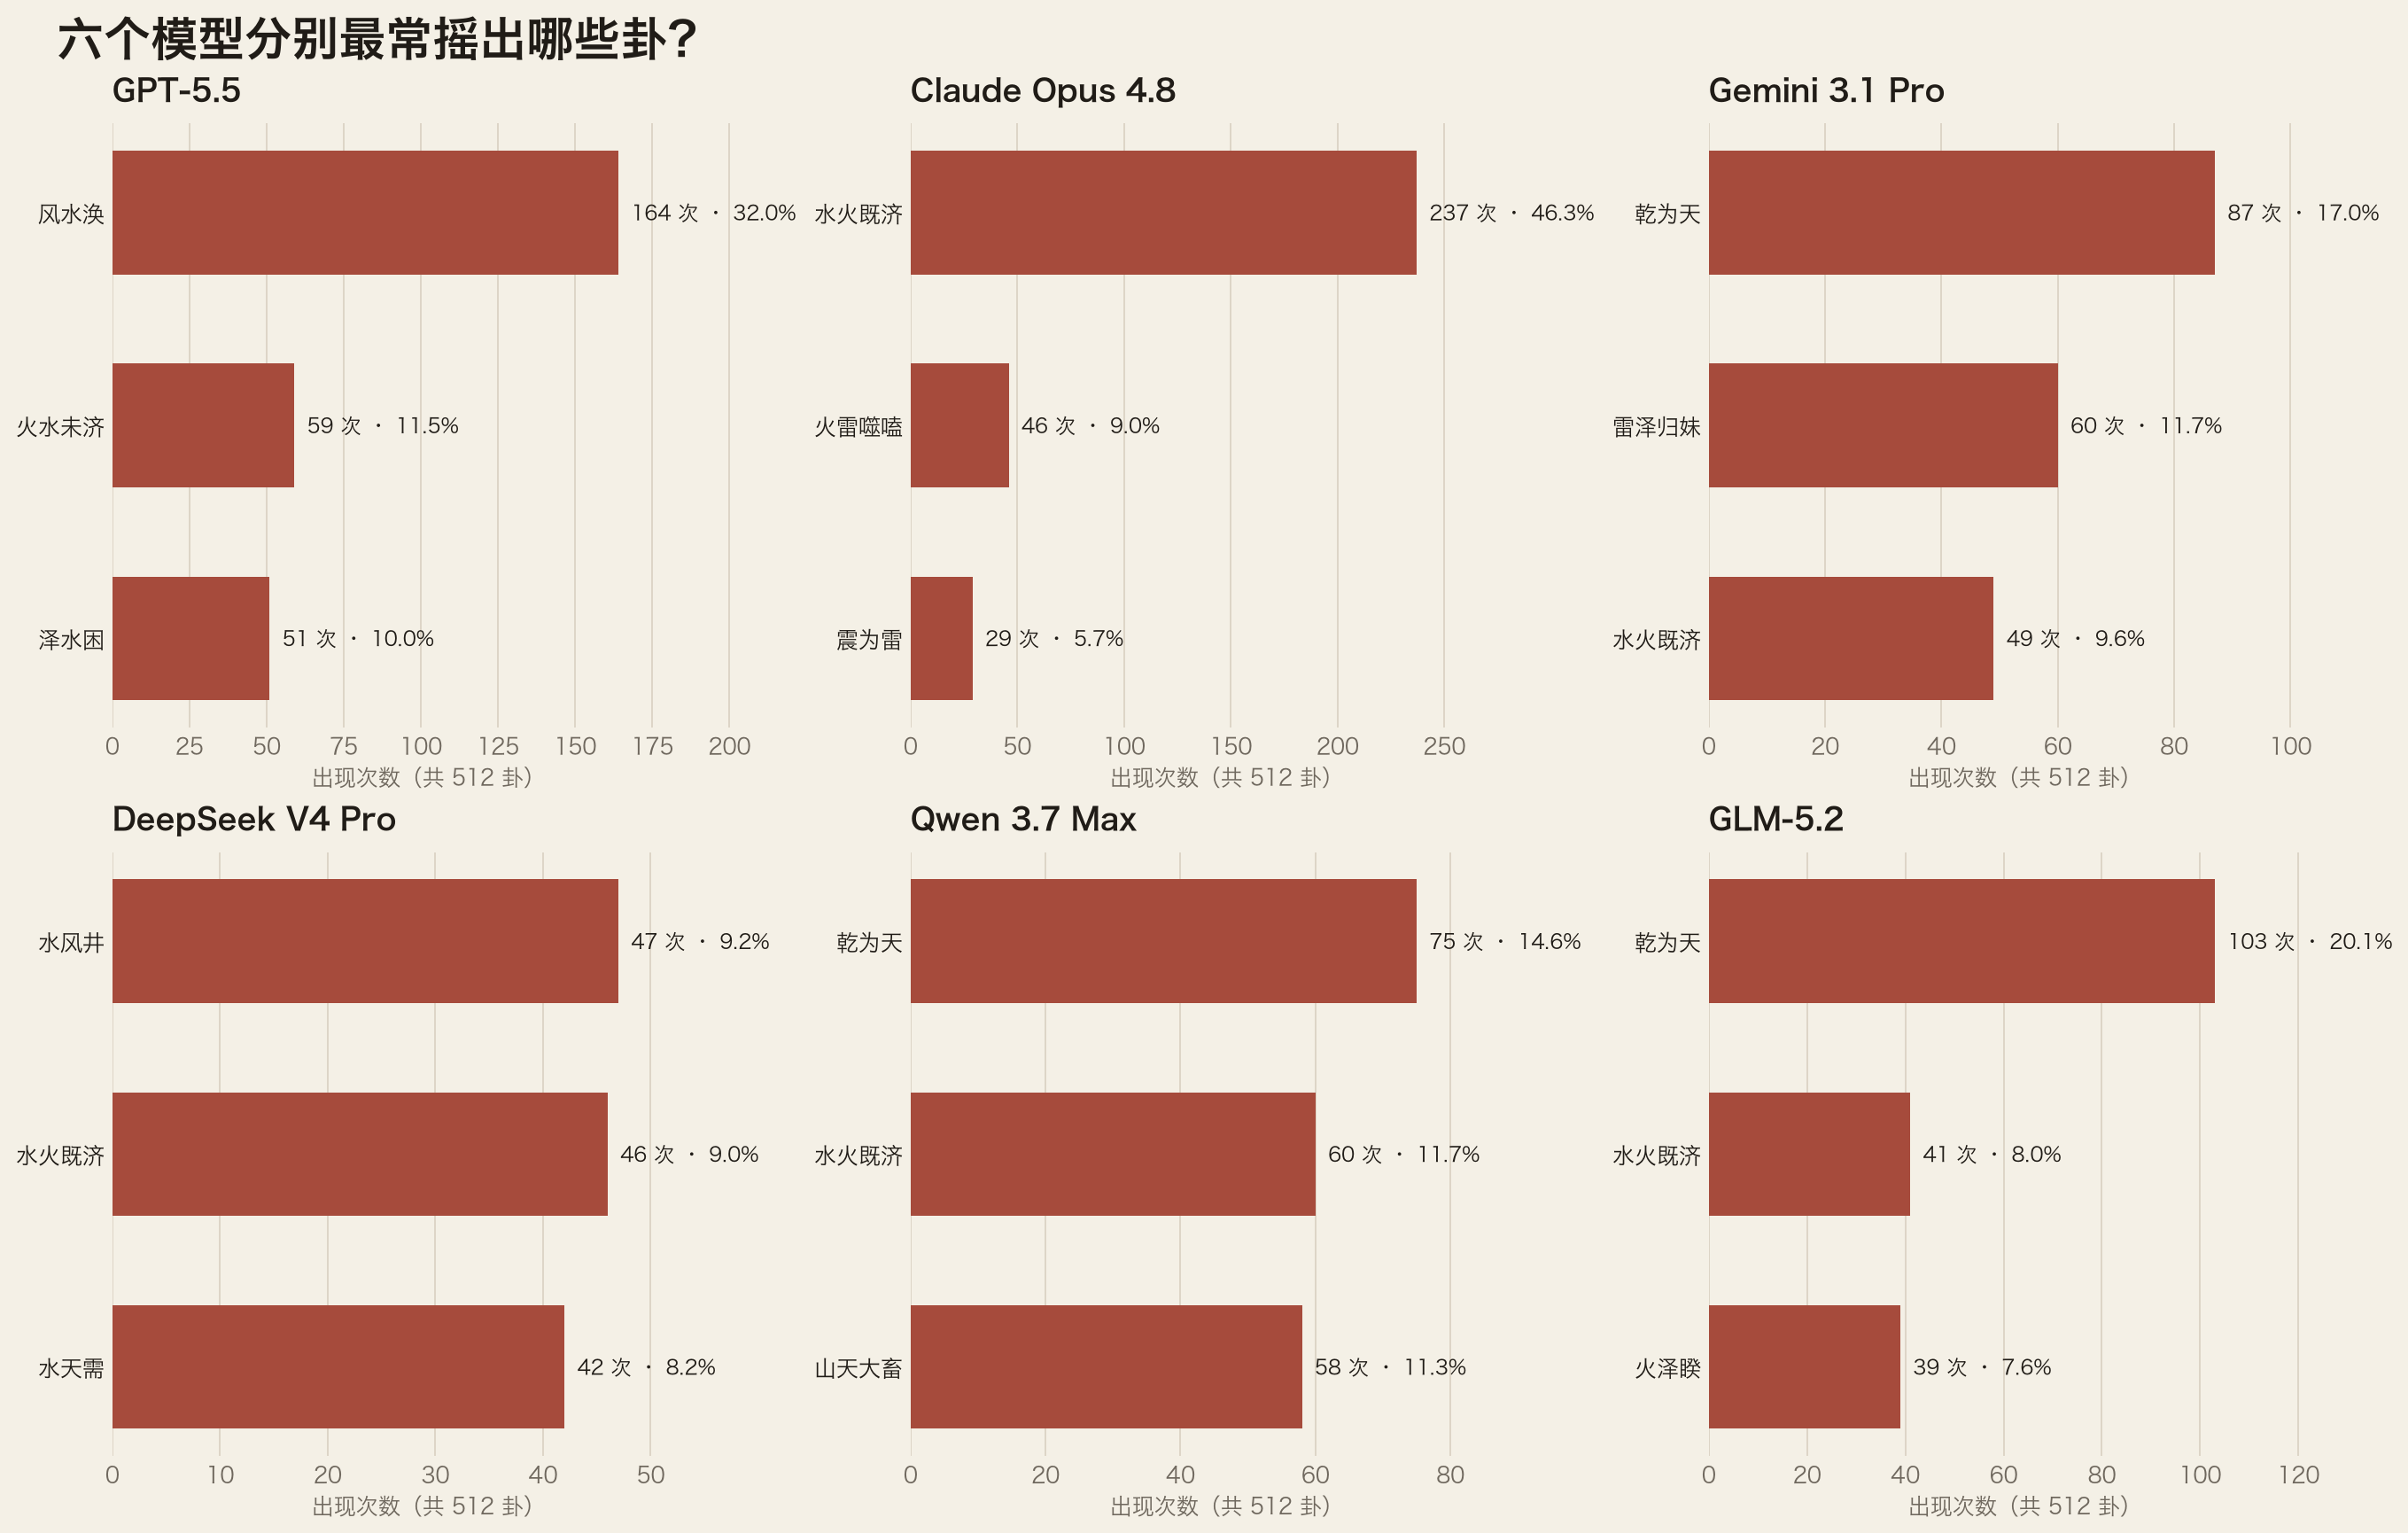
图四:这是四种问法合并后的描述统计,不是模型能力排名。
不同模型的偏好并不相同。Claude Opus 4.8 的结果高度集中在水火既济;GPT-5.5 更常生成风水涣;Gemini、Qwen 和 GLM 合并后都以乾为天居首;DeepSeek 的分布相对分散,整体第一名是水风井。
24 组结果:偏好属于“模型 × 问法”
只看总榜会掩盖一个重要事实:偏好不是只属于模型,也不是只属于提示词,而是两者共同形成的。下面列出全部 24 组各自的第一名;每一组都来自 128 个有效卦。四个数字依次对应“说铜钱一次六爻、不说铜钱一次六爻、一次给出 18 位数字、逐爻生成”。
GPT-5.5
- 说铜钱、一次六爻:风水涣 80(62.5%)
- 不说铜钱、一次六爻:风水涣 64(50.0%)
- 一次给出 18 位数字:泽水困 46(35.9%)
- 逐爻生成:乾为天 7(5.5%)
Claude Opus 4.8
- 说铜钱、一次六爻:水火既济 113(88.3%)
- 不说铜钱、一次六爻:水火既济 86(67.2%)
- 一次给出 18 位数字:火雷噬嗑 46(35.9%)
- 逐爻生成:乾为天 27(21.1%)
Gemini 3.1 Pro
- 说铜钱、一次六爻:雷泽归妹 30(23.4%)
- 不说铜钱、一次六爻:地天泰 21(16.4%)
- 一次给出 18 位数字:水泽节 18(14.1%)
- 逐爻生成:乾为天 87(68.0%)
DeepSeek V4 Pro
- 说铜钱、一次六爻:水天需 32(25.0%)
- 不说铜钱、一次六爻:水火既济 33(25.8%)
- 一次给出 18 位数字:离为火 17(13.3%)
- 逐爻生成:乾为天 31(24.2%)
Qwen 3.7 Max
- 说铜钱、一次六爻:地天泰 39(30.5%)
- 不说铜钱、一次六爻:离为火 31(24.2%)
- 一次给出 18 位数字:山天大畜 41(32.0%)
- 逐爻生成:乾为天 75(58.6%)
GLM-5.2
- 说铜钱、一次六爻:水天需 27(21.1%)
- 不说铜钱、一次六爻:水火既济 20(15.6%)
- 一次给出 18 位数字:火泽睽 20(15.6%)
- 逐爻生成:乾为天 103(80.5%)
GLM-5.2 是最直观的例子:说到铜钱并一次生成六爻时,第一名是水天需;改成一次输出 18 位数字,第一名变成火泽睽;改成逐爻生成,乾为天占到 80.5%。模型没有换,生成方式一换,结果就变了。
不只是某一卦多:数字模板也会重复
模型逐字生成 0 和 1 时,某些局部组合会比其他组合更容易被续写。相同的六爻数字模板反复出现,最终自然会聚集到少数卦象。下面这张图展示了各组中最常见模板的重复程度。
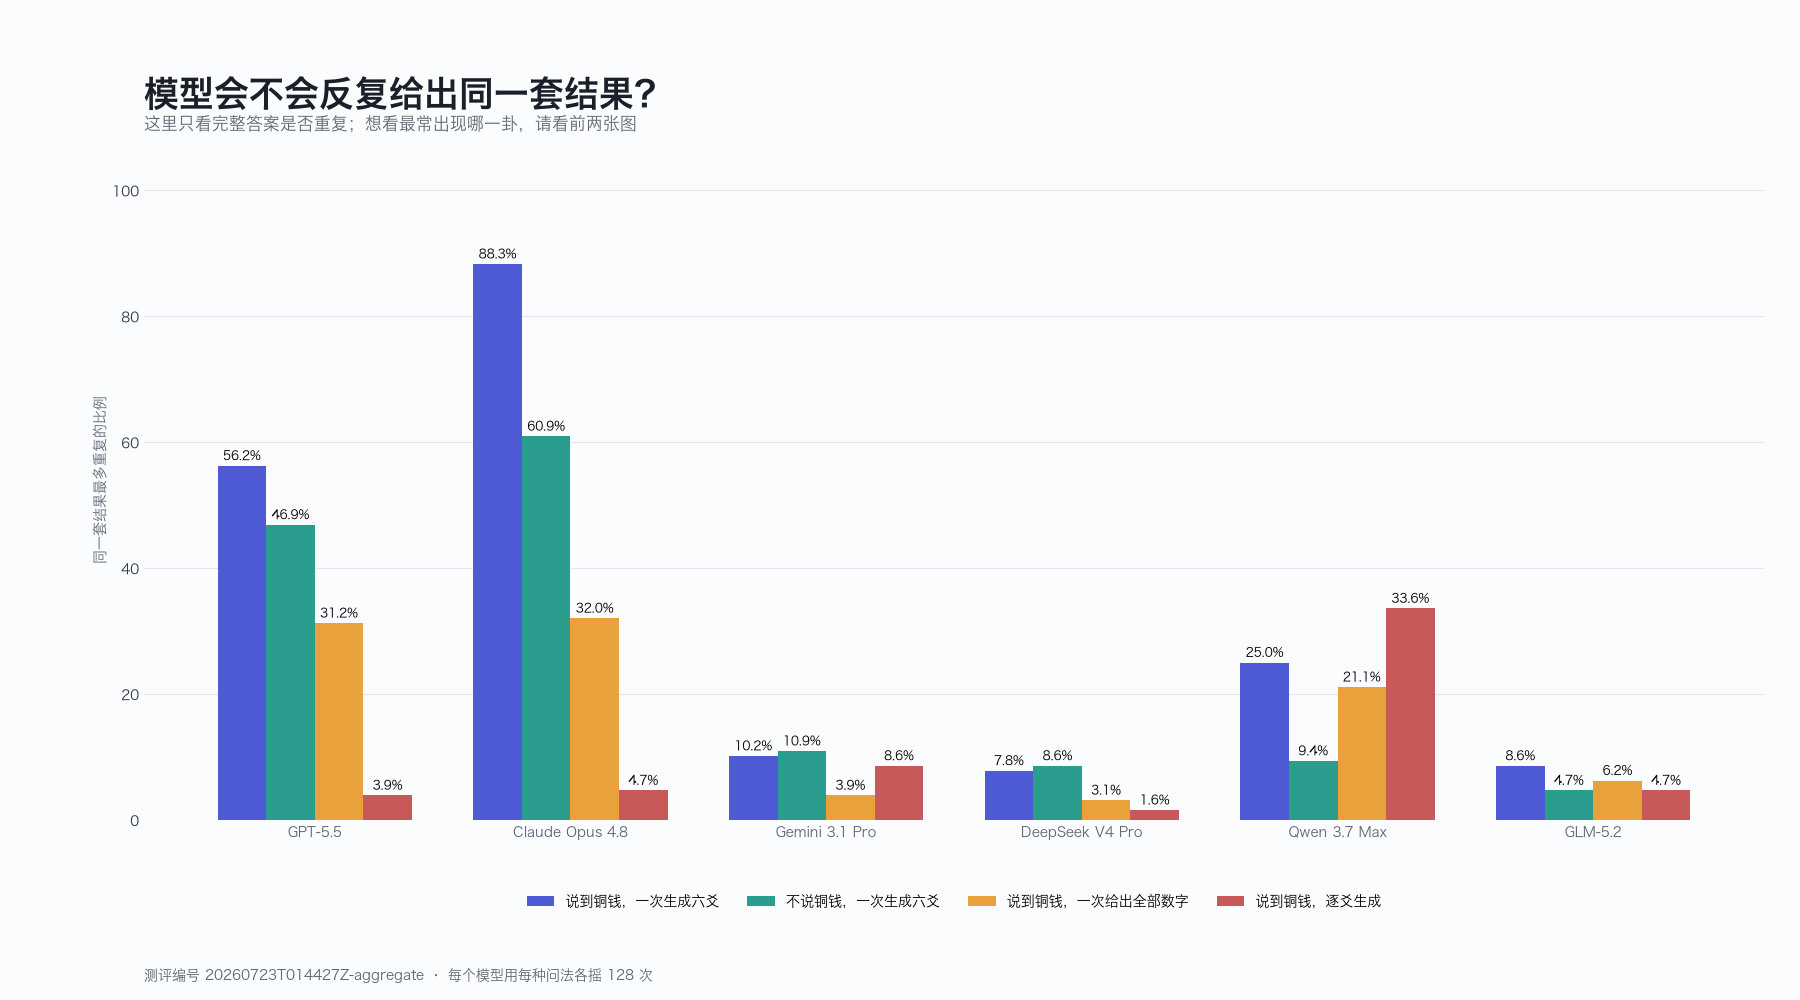
图五:模板重复越高,说明结果越集中在少数固定的 0/1 写法上。
这也解释了为什么“每次答案会变”仍然不等于“公平随机”。一个模型可以在几个高概率模板之间变化,但只要这些模板被选择的机会不相等,最终卦象就不会均匀。
为什么大模型会有这些偏好
数据能直接证明“出现了偏好”和“偏好会随问法变化”。至于模型内部为什么恰好偏向水火既济、乾为天或风水涣,下面是与语言模型工作方式一致的解释,但不是对隐藏参数的直接观测。
1. 每一位不保证一半是 0、一半是 1
语言模型的基本动作是:根据前文,为下一个词元分配概率,再进行随机采样。它会变化,但并没有一条规则强制 0 和 1 各占 50%。温度等采样参数只能改变分布的平缓程度,不能自动把它变成公平硬币。
2. 前后数字并不天然独立
真实铜钱的下一次结果不应该被上一次影响;语言模型却必须根据已经写出的内容继续写。前一位是 0 还是 1、当前已经出现了什么模式,都会改变下一位的概率。连续生成 18 位数字尤其容易形成重复、对称或模型熟悉的序列。
3. 问法会改变模型正在续写的文本
“请模拟三枚铜钱”和“只输出 0/1”会唤起不同的语言上下文;一次写完与逐爻请求又改变了生成边界。模型处理的是文本条件概率,而不是抽象的铜钱实体,所以提示词和输出结构都会进入结果。
4. 训练文本与对齐习惯可能提供先验
乾、既济、泰等卦在中文文化文本中有较高辨识度;“随机数字”也常与交替、平衡、避免长串重复等人为直觉一起出现。这些训练痕迹可能影响数字续写。但仅凭本次输出,不能断言某个具体卦是由哪一批训练材料造成的,这一点仍需要更细的机制实验。
这次实验能说明什么,不能说明什么
它能说明:
- 在本次实际路由的六个模型、四种问法和采样设置下,生成的卦象明显不是均匀分布;
- 六个模型都出现了自己的高频卦;
- 同一模型换一种问法,偏好的卦和集中程度会明显变化;
- 因而,不能把语言模型直接生成的 0/1 当成三枚公平铜钱。
它不能说明:
- 模型“永远”偏爱某一卦。模型版本、路由、采样参数和提示词变化后,结果可能变化;
- 某个模型更聪明或更适合解卦。这里测的是生成随机结果的行为,不是推理或解释能力;
- 已经定位了每一种偏好的唯一内部原因。本实验观察到现象,机制解释仍需要更多对照;
- 真实起卦或卦义本身是否有效。这不是本次测评的问题。
如果目标是公平起卦,更可靠的做法很简单:用真实铜钱,或用经过检验的随机数来源生成卦,再让大模型负责解释。“生成卦”和“解读卦”是两种工作,不应该因为都能由 AI 输出文字就混为一谈。
原始数据与复核材料
为了让结论可以复算,这次公开三个层级的文件:
- 3,072 条有效结果 CSV:每一条完整卦的模型、问法、六爻结果和卦名;
- 机器可读汇总 JSON:总体、按问法、按模型以及 24 个组合的完整计数;
- 离线审计报告 HTML:实验批次、实际路由模型、统计图和方法说明。
图表全部由这些有效结果直接统计生成,没有用图片生成模型重画数据。你可以下载 CSV 自己分组计数;每个模型应为 512 条,每种问法应为 768 条,每个“模型 × 问法”组合应为 128 条,总数应为 3,072 条。
这次最值得记住的不是“哪一卦赢了”,而是:会变化,不等于公平随机;模型的偏好,也会被我们的问法塑造。